Agent 的对话越长,需要处理的上下文通常也越多。用户输入、模型回复,以及工具调用产生的结果,都可能进入后续请求的上下文。
但模型能接收的上下文有长度限制,也不是所有历史信息都值得一直保留。因此,需要在保留重要信息和控制上下文长度之间做取舍。
滑动窗口
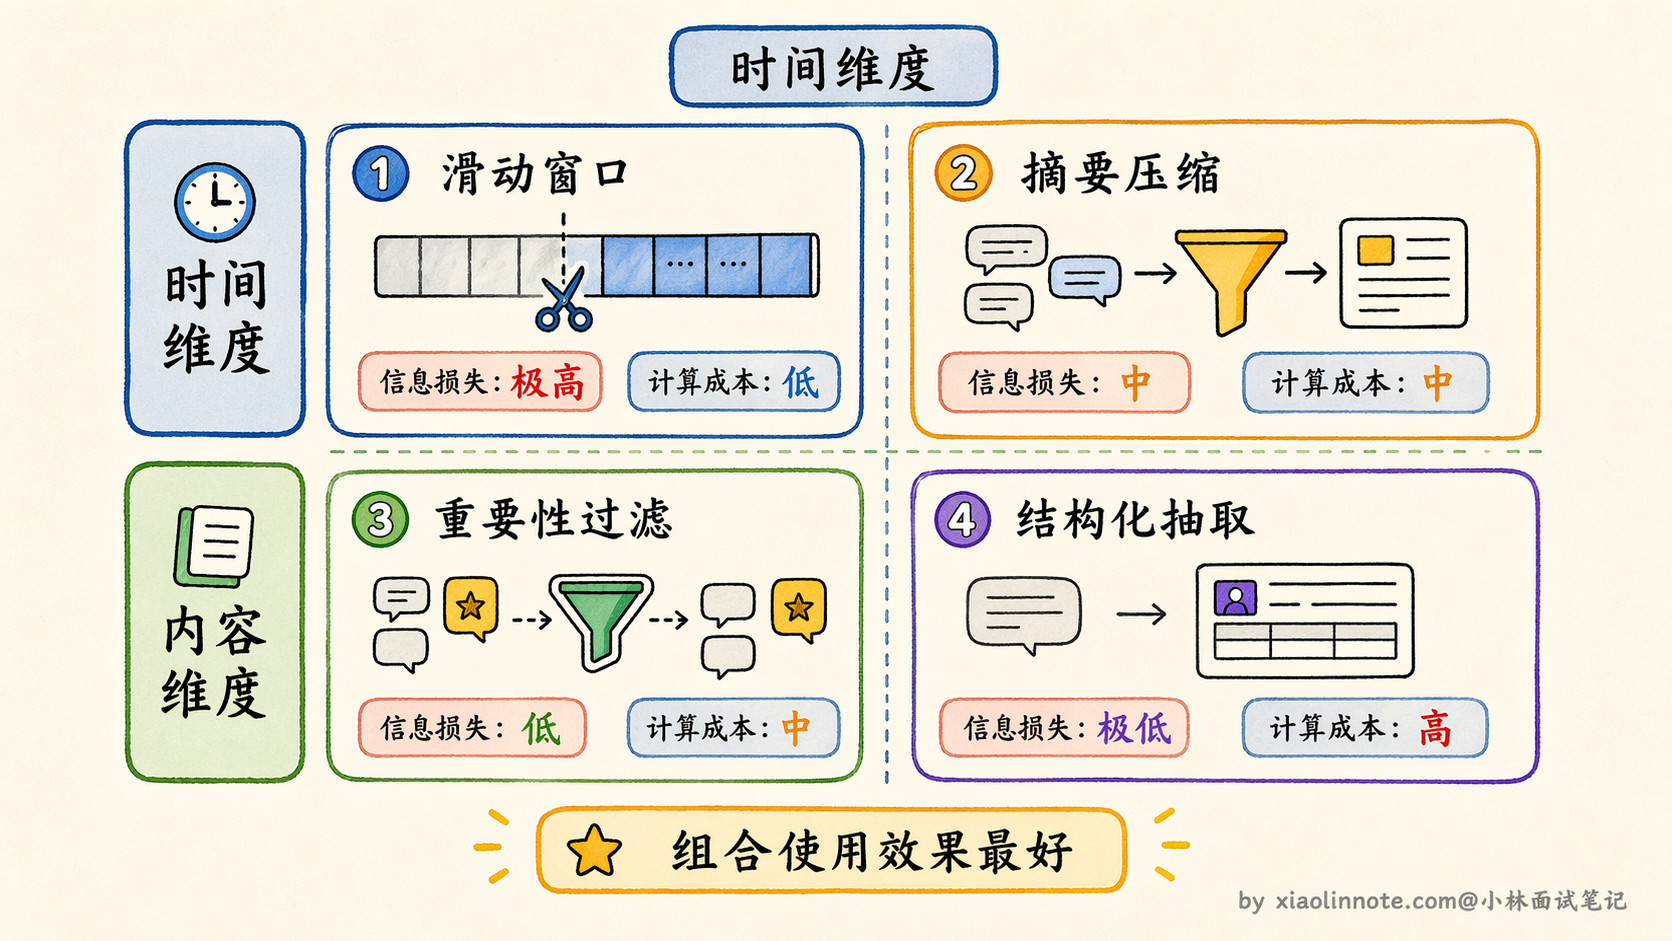
滑动窗口是最简单的方法:只保留最近的一部分历史,超出窗口的内容直接移出上下文,不依赖 LLM 生成摘要。
它的坏处也很直接:硬截断可能丢掉早期的重要决策。如果没有另外保存这些信息,后续就无法从当前上下文中找回。
摘要压缩
摘要压缩会先让 LLM 将较早的历史总结成摘要,再用摘要替换原始对话。通常会保留最近的原文,将更早的内容压缩。
代价是细节可能丢失。摘要保留什么、忽略什么,会受到提示词和模型判断的影响。
还可以做成层级式摘要。例如,最近 10 轮保留原文,第 11~50 轮整理成中期摘要,更早的内容整理成长期摘要。这里的轮数只是举例,具体要根据任务和上下文预算调整。
工程上也可以把摘要和滑动窗口结合起来:保留近期对话,同时用摘要承接更早的信息。
重要性过滤
重要性过滤不只按时间筛选,而是按信息价值决定保留哪些内容。例如,对历史信息打分,保留超过阈值的部分,丢弃低价值内容。
这样可以让较早但重要的决策继续留在上下文里,不过也依赖评分是否可靠:一旦把重要信息评低,仍然可能丢失。
结构化抽取
结构化抽取只提取重要的事实和状态,例如目标、约束、已确认的决策、当前进展和待办事项。
可以把它理解成医生整理的病历:保留下次接手时需要知道的关键信息,而不是逐句记录所有对话。
主动压缩
主动压缩更像是一种压缩时机的选择,可以和前面的方法配合使用。
它不必等到上下文窗口快满才开始处理,而是在任务执行过程中,及时判断哪些中间结果可以压缩或移出上下文,从源头控制上下文增长。
图片来源:小林 coding。
Prompt Caching
理解 Prompt Caching 之前,先看一下 prefill:模型在生成回答前,需要处理输入的 token。如果请求中包含固定的系统提示词和不断增长的对话历史,前面的部分就可能被重复处理。
Prompt Caching 的思路是复用已处理过的相同前缀,减少重复计算,从而降低部分输入处理的延迟和费用。具体的命中条件、计费方式和效果取决于使用的模型服务。
前面的记忆压缩是在减少或重组上下文;Prompt Caching 则是在计算层面复用已有结果。它本身不会缩短输入内容,也不能替代记忆压缩。