整理一下 Agent 的基础概念:它需要哪些能力,内部可以怎样拆分,以及一次任务是怎么跑起来的。
Agent 的三类核心能力
可以先从三个方面理解 Agent 的能力,这是一种学习时的划分,不是统一标准。
- Tool use:工具调用。 通过工具查询信息、执行命令或操作外部系统。
- Memory:记忆。 保留当前任务的上下文,并在需要时找回跨任务的信息,例如用户偏好和历史决策。
- Reasoning:推理。 根据目标和执行反馈决定下一步,必要时调整做法。
比如,LLM 给出指令 A,在终端执行后没有找到有效信息;系统把结果反馈给模型,模型再给出指令 B。如果仍然报错,就根据新的反馈继续调整。有一种边做边反思、不断试探的感觉。
Agent 的四个核心组件
从实现角度,可以把系统拆成 LLM、工具、记忆和规划模块。这里的拆分是为了便于理解,并不意味着它们必须是四个独立服务。
LLM:做决策的大脑
用户输入、工具返回结果、检索到的记忆等信息,会被组织成上下文,交给 LLM 判断下一步该做什么。输出可能是工具调用,也可能是直接回答。
System Prompt 会影响模型的角色、行为准则和任务边界,是上下文中的重要组成部分。
选择模型时,需要在能力、成本和延迟之间做取舍。例如,将复杂规划交给能力更强的模型,把较简单的格式提取交给成本较低的模型;能用确定性代码完成的正则匹配,也不一定需要模型参与。
还要关注模型能否正确选择工具、生成符合要求的参数,以及上下文长度和复杂任务的处理能力。
工具:把决策变成动作
工具定义通常包含名字、描述和参数结构;真正的执行逻辑由应用或工具服务实现。模型生成调用请求后,系统执行相应逻辑,再把结果送回模型。
下面是一个便于理解的调用示意,不代表某个 API 的完整格式:
{
  "tool_call": {
    "name": "search_web",
    "arguments": {
      "query": "Agent 的基础概念"
    }
  }
}
工具描述的质量会影响模型的选择。比如,查询成绩的工具只写了“查询数据”,模型就很难判断它的适用范围。描述应该说明具体用途、参数含义和使用条件。
MCP:连接工具与上下文的协议
MCP 提供了一套基于 JSON-RPC 的通信约定,让 AI 应用连接外部工具和上下文。服务端提供的三类主要能力包括:
- Tools: 可调用的操作,例如查询天气、检索数据库或发送邮件。工具既可以只读,也可以改变外部状态。
- Resources: 可读取的上下文数据,例如文件内容。
- Prompts: 可复用的提示词模板。
架构上,Host 是 AI 应用,其中的 Client 负责连接 Server;Server 提供工具和上下文。Host 并不等同于 LLM 本身。具体概念可以参考 MCP 架构文档。
记忆:保留任务状态与历史信息
短期记忆可以理解成当前任务中使用的上下文,例如对话历史和工具结果。上下文过长时,可以用滑动窗口、摘要等方式控制长度。开启新对话后是否保留这些信息,取决于应用有没有保存和恢复机制。
长期记忆用于跨会话保留信息。可以将信息 embedding 后存入向量数据库,再通过语义检索和 metadata 过滤找回相关内容;也可以使用结构化数据库或文件,不一定依赖向量检索。
如果什么都存,检索结果里可能混入大量噪音;存得太少,又失去了长期记忆的意义。因此,可以在写入前评估信息的重要性,优先保留稳定、有复用价值的内容。
另一种思路是 memory decay(记忆衰减):让部分信息的权重随时间降低。是否衰减、怎样衰减,要根据业务需求决定,不能把仍然有效的重要事实直接当成过期信息。
讨论记忆时,还会遇到语义记忆、情景记忆、程序性记忆等分类。事实性知识通常可以归入语义记忆,具体分类方式会随框架和讨论语境变化。
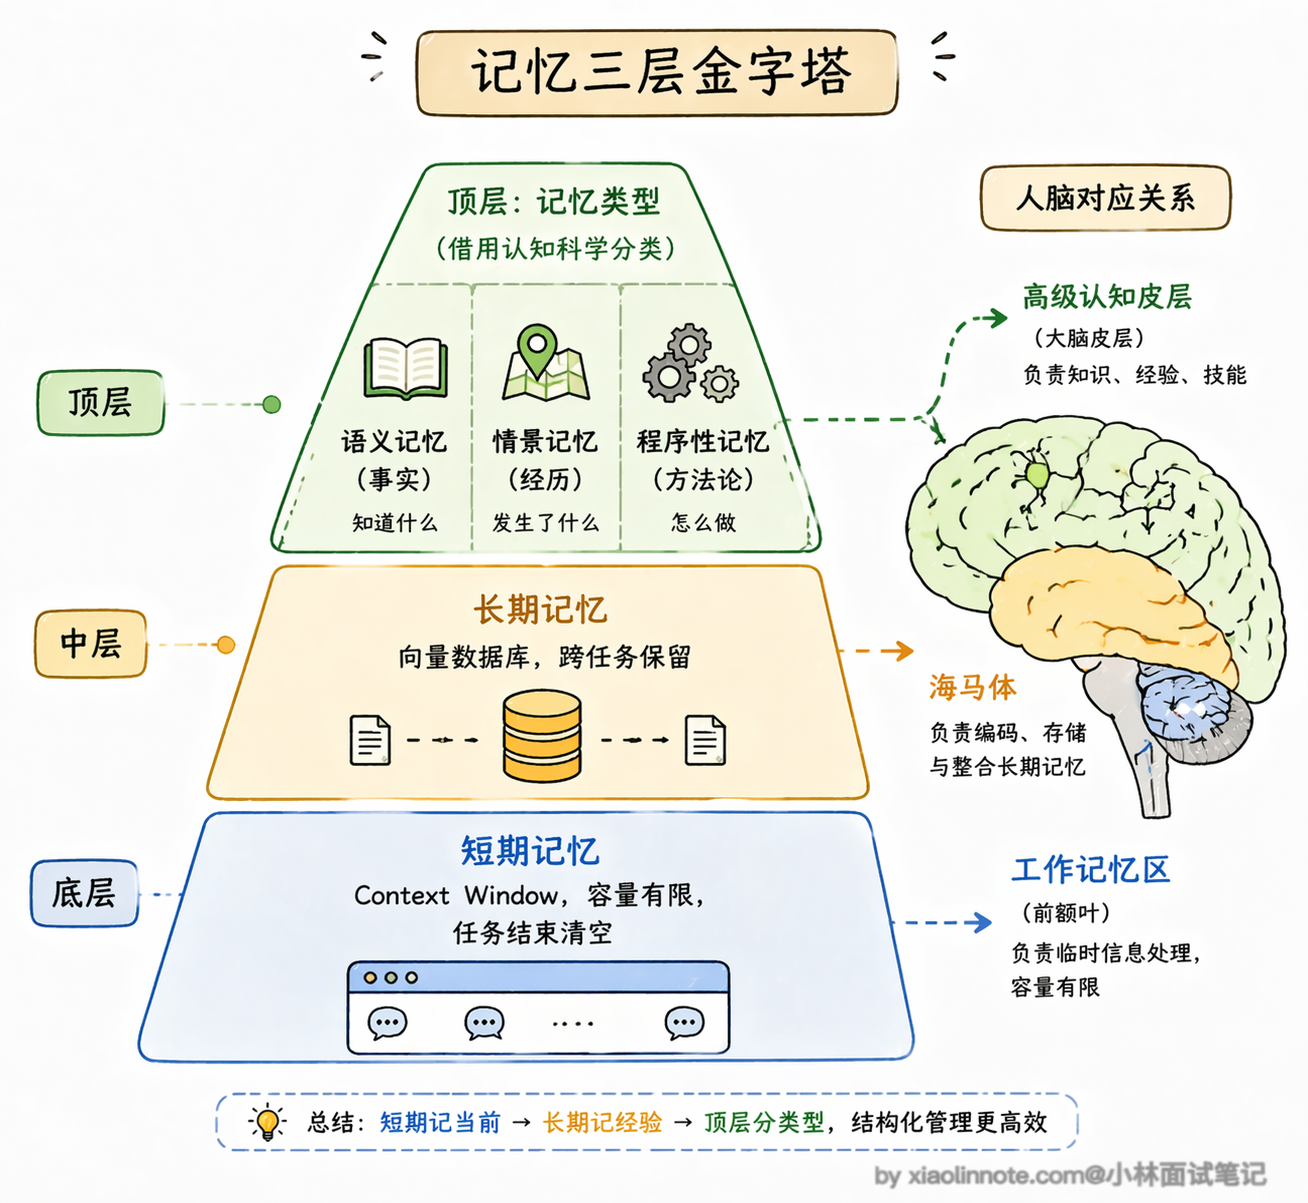
图片来源:小林 coding。
规划模块:决定怎样完成目标
笔记里经常会遇到 CoT、ToT、Plan-and-Execute 和 ReAct 等概念。它们讨论的层次并不完全相同,这里先关注任务执行时的两种组织方式。
Plan-and-Execute 先把目标拆成步骤,再按计划执行。好处是能提前看到任务路径;如果某一步失败或环境变化,后续就需要重新评估和调整计划。
ReAct 将推理与行动交替进行:执行动作、观察结果,再决定下一步。它更便于根据反馈调整,但也可能出现重复尝试或偏离目标,因此仍然需要任务边界和停止条件。它不必然是贪心算法,也不保证每一步局部最优。
一种组合方式是先做粗略计划确定方向,再根据执行反馈动态调整。关于预定义工作流与模型动态决策的区别,也可以参考 Anthropic 的 Agent 构建文章。
Agent 运行的核心循环
下面是一个先规划、再执行的简化伪代码,只用于展示组件间的关系,不是完整可运行实现:
def agent_run(user_goal: str):
    plan = llm.plan(user_goal)
    memory = []

    for step in plan:
        action = llm.decide(
            step=step,
            history=memory,
            long_term=memory_store.search(step),
        )

        if action.type == "tool_call":
            result = tools.execute(action.tool_name, action.args)
            memory.append({"step": step, "result": result})

        elif action.type == "final_answer":
            return action.content

    return llm.summarize(user_goal, memory)
整体链路可以理解为:接收目标,规划任务,将当前上下文和检索到的长期记忆交给模型,决定并执行工具调用,再把结果放回上下文。系统根据反馈继续决策,任务完成后返回答案。
实际实现还需要处理工具异常、执行次数限制和重新规划等问题;上面的伪代码省略了这些细节。