Tool、Agent 和 Workflow 可以先这样理解:
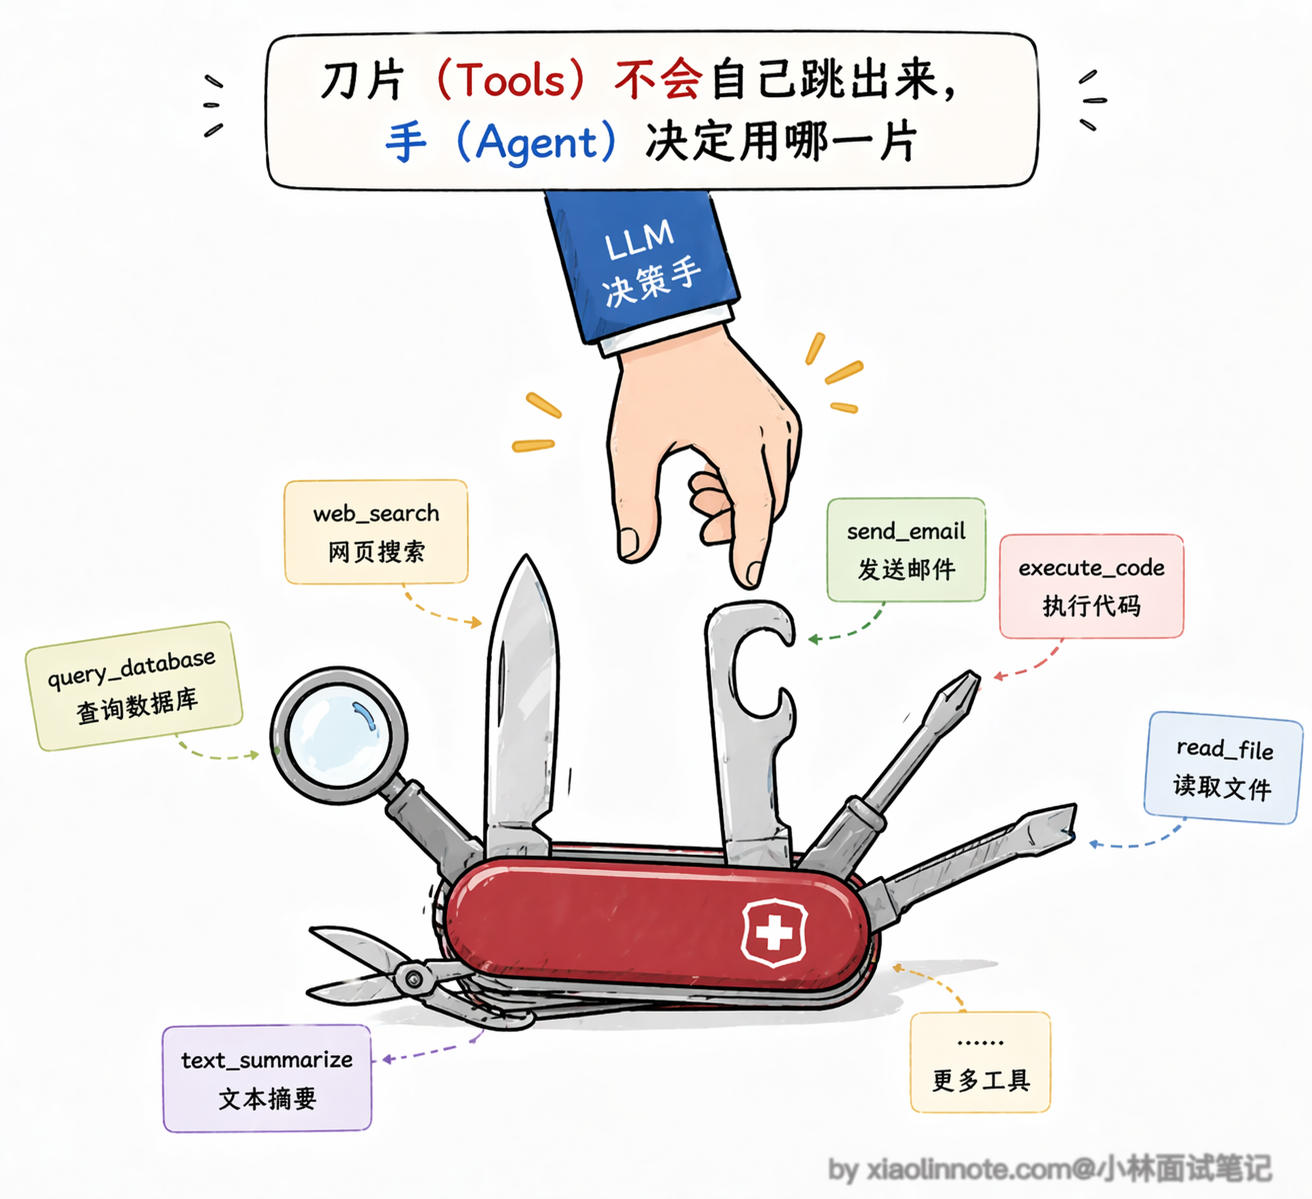
- Tool 是能力的最小单元:封装好的可调用函数,比如查天气、发邮件、搜索,本身不负责决策。
- Agent 是一个决策系统:由 LLM 判断下一步该做什么,调用 Tool,并根据结果继续推进任务。
- Workflow 是预先编排的流程:由开发者安排节点、执行顺序和分支规则。
Tool:封装好的能力
使用 Tool 时,会把包含名称、用途和参数 schema 的工具说明提供给 LLM,让它知道有哪些工具、该如何调用。实际执行调用的函数则由程序提供。
图片来源:小林 coding。
Agent:循环决策,推进任务
Agent 会根据用户目标和已有的执行结果,判断下一步要调用什么工具,以及什么时候结束。下面用一段简化代码展示这个循环,其中 tools 和 execute_tool 需要另外定义:
import anthropic

client = anthropic.Anthropic()

def run_agent(user_goal: str):
    # 把用户目标放进对话历史,Agent 的所有思考和行动都在这个 messages 里积累
    messages = [{"role": "user", "content": user_goal}]

    # Agent 的核心:一个不断循环的决策过程
    # 注意:开发者根本不知道这个循环会跑几次,完全由 LLM 自己决定
    while True:
        # 每一轮,LLM 看到当前的完整对话历史,自己判断下一步该做什么
        response = client.messages.create(
            model="claude-opus-4-6",
            max_tokens=1024,
            tools=tools,      # 把「工具说明书」传给 LLM,让它知道自己有哪些能力
            messages=messages
        )

        # LLM 告诉我们「任务完成了」,把最终答案返回出去,循环结束
        if response.stop_reason == "end_turn":
            return response.content[0].text

        # LLM 认为还需要调工具,我们就真正去执行它指定的工具
        # 注意:LLM 只是「告诉我们调哪个工具、传什么参数」,真正执行的是我们的代码
        tool_use = next(b for b in response.content if b.type == "tool_use")
        tool_result = execute_tool(tool_use.name, tool_use.input)

        # 把工具的执行结果塞回对话历史,LLM 下一轮能看到这个结果,再接着决策
        messages.append({"role": "assistant", "content": response.content})
        messages.append({
            "role": "user",
            "content": [{"type": "tool_result", "tool_use_id": tool_use.id, "content": tool_result}]
        })
        # 回到循环顶部,LLM 再看一遍现在的状态,做下一步决策
什么时候停止?
Agent 的循环可以通过以下条件结束:
- 自然结束:Agent 判断任务已经完成。
- 轮数限制:达到最大执行轮数。
- Token 用量限制:达到设定的 Token 预算。
- 超时限制:超过指定时长,比如 60 秒。
如何排查执行过程?
Agent 的不确定性和灵活性往往相伴而生。在生产环境中,通常会为每次运行加上 trace_id,方便回溯和排查整个执行链路。
Workflow:按预设规则编排流程
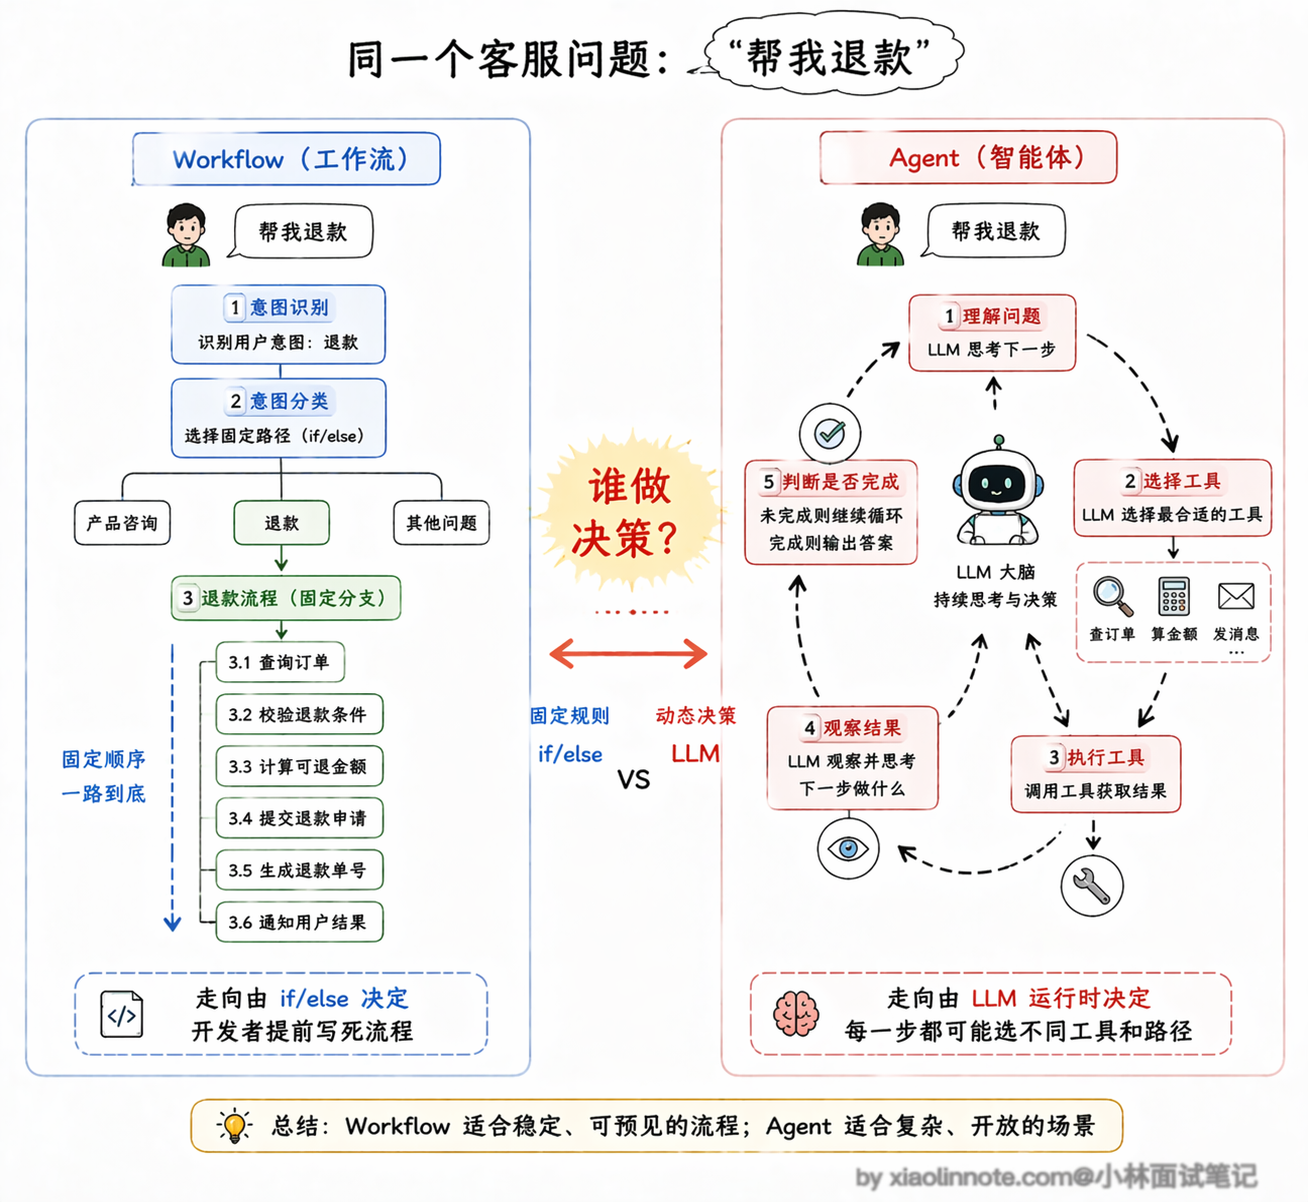
LLM、Tool 和 Agent 都可以作为 Workflow 中的节点。开发者预先定义节点之间的连接与分支规则,执行时根据输入和中间结果选择对应路径。
图片来源:小林 coding。
下面以客服流程为例,展示如何按问题类别进入不同分支。其中各个函数是示意,需要另外实现:
def run_customer_service_workflow(user_query: str) -> str:
    # ---- 第一步:意图识别 ----
    # 这里把 LLM 当成一个分类器来用,它只负责判断这个问题属于哪个类别
    # 「下一步去哪」这个决策是下面的 if/elif 来做的,不是 LLM 自己决定的
    intent = classify_intent_with_llm(user_query)  # 返回 "product" / "refund" / "other"

    # ---- 第二步:根据意图走不同分支 ----
    # 注意:这个分支判断是开发者写的 Python 代码,不是 LLM 的决策
    if intent == "product":
        # 产品问题:去知识库检索,再生成回答
        docs = search_knowledge_base(user_query)    # 直接调 Tool,固定的检索步骤
        answer = generate_answer_with_llm(user_query, docs)  # LLM 作为节点生成回答
        return answer

    elif intent == "refund":
        # 退款问题:查订单系统,再走审核流程
        order_info = query_order_system(user_query)  # 调 Tool 查订单
        if order_info["eligible"]:
            process_refund(order_info["order_id"])   # 调 Tool 处理退款
            return "退款已受理,预计 3 个工作日到账"
        else:
            return "很抱歉,该订单不满足退款条件"

    else:
        # 其他问题:转人工
        escalate_to_human_agent(user_query)
        return "已为您转接人工客服,请稍候"

 # 整个流程的走向在代码里一目了然
 # 出了任何问题,你可以精确定位是哪一步出了错
这种流程通常更容易控制和预测,成本也更容易管理;代价是灵活性有限,预设流程之外的问题处理起来会比较僵硬。
Workflow 和 Agent 如何组合?
一种常见做法是用 Workflow 搭建主流程的骨架:需要灵活判断的节点使用 Agent,其余节点根据需要使用 LLM 或 Tool。
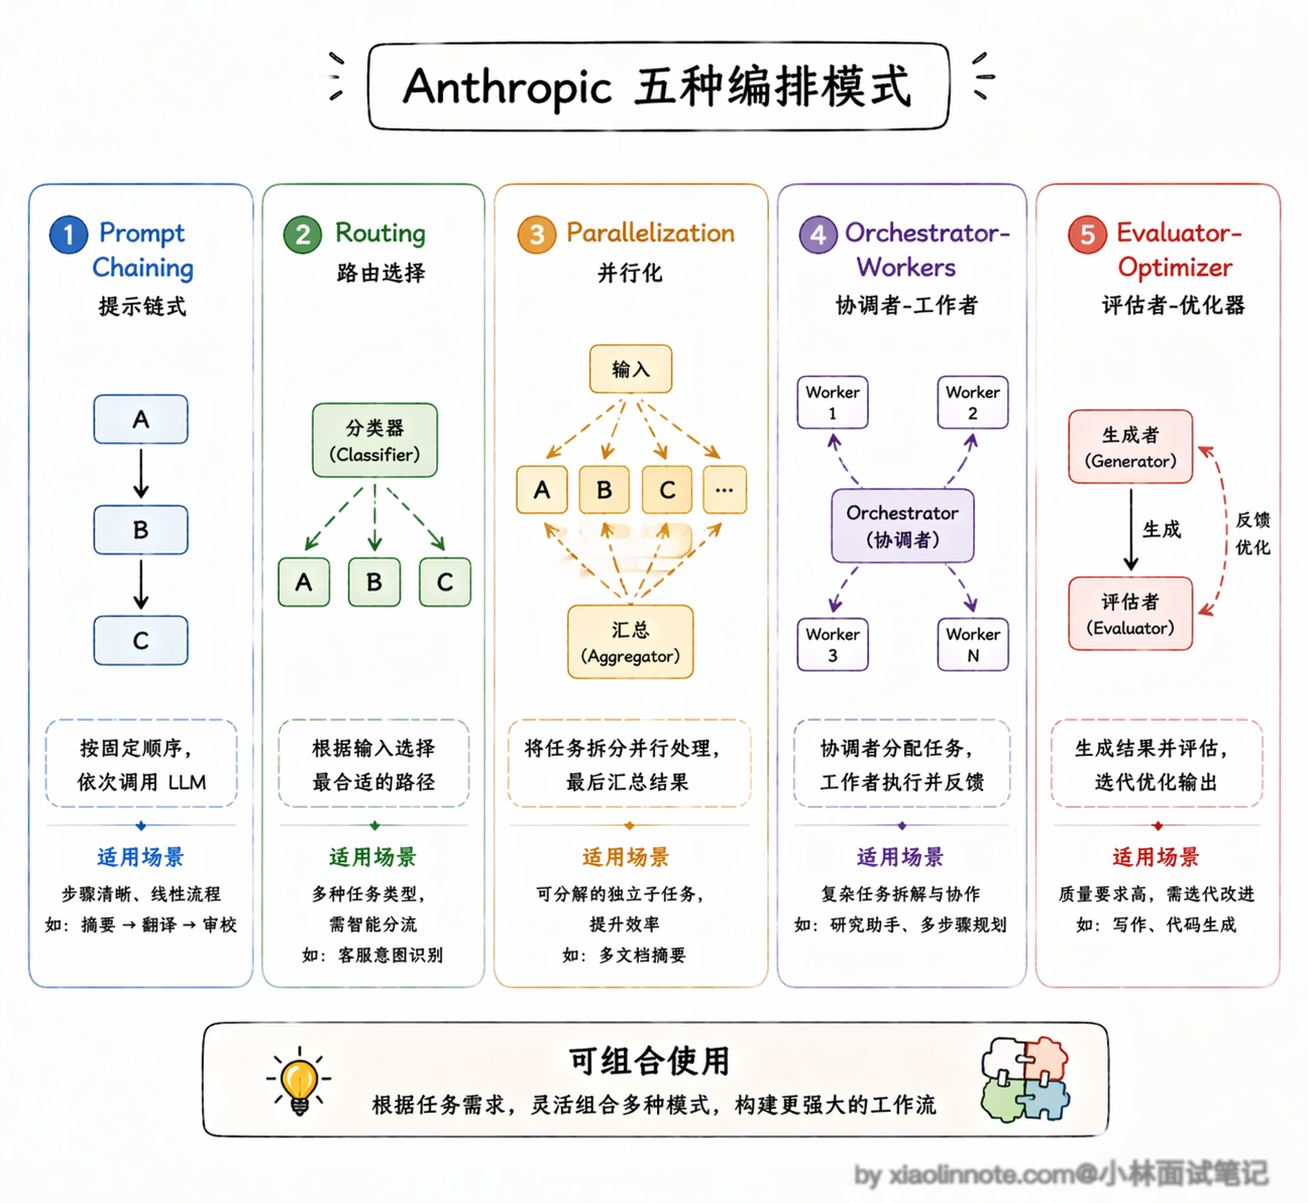
常见的 Workflow 编排模式
1. Prompt Chaining:提示词链
把一个大的任务拆分成多个小步骤,前一步的输出作为下一步的输入,逐步完成整个任务。
2. Routing:路由
让 LLM 判断输入属于哪个类别,再根据分类结果发送到不同的处理分支。前面的客服示例就采用了这种方式。
3. Parallelization:并行化
把可以同时进行的子任务并行执行,最后汇总结果。适合需要多维度分析的场景,比如同时从多个数据源检索信息。
4. Orchestrator-Workers:编排者与工作者
由一个中央编排者分配任务,多个 Worker 各自完成子任务,再汇总结果。可以类比主 Agent 向子 Agent 分发任务。
5. Evaluator-Optimizer:评估者与优化者
一个 LLM 负责生成输出,另一个 LLM(或者同一个模型换一个角色)负责评估输出质量。如果评估不通过,就把反馈交给生成者,让它改进后重新输出,直到评估通过或达到最大重试次数。
这不就是我常常把 GPT 的方案给 Claude 来判断吗,哈哈哈哈哈。
图片来源:小林 coding。